生成AIを社内業務で本格的に活用したい。
一方で、
といったセキュリティやデータ管理上の課題を抱える企業も少なくありません。
そこで選択肢となるのが、企業専用の環境でLLM(大規模言語モデル)を稼働させるローカルLLM/プライベートLLMです。
しかし、導入を検討すると多くの企業が最初に疑問を持つのが、
という費用です。
ローカルLLMの費用は、単純に「AIモデルの価格」だけでは決まりません。利用人数、同時利用人数、AIモデルの規模、GPU、稼働時間、RAG、セキュリティ、冗長化などによって、必要となるシステム構成と費用は大きく変わります。
本記事では、企業向けローカルLLM基盤の設計例をもとに、専門的なAI知識がない方にも分かるように、企業規模・GPU・利用人数別にローカルLLMの費用の考え方を解説します。
※本記事で紹介する金額は、ローカルLLM基盤を検討するための構成・概算例です。クラウド料金、為替、GPUの提供状況、利用時間、システム要件などによって実際の費用は変動します。
ローカルLLMとは?
ローカルLLMとは、企業が管理する専用環境でLLMを稼働させる仕組みです。一般的なクラウド型生成AIサービスでは、インターネットを通じて外部サービスのAIを利用します。
これに対してローカルLLMでは、企業専用のクラウド環境やオンプレミス環境などにLLMを配置し、自社の管理下で生成AIを利用します。
例えば、企業専用環境でopen-weight(オープンウェイト)のLLMを稼働させ、通常運用では外部のLLM APIを利用しない構成が考えられます。このような構成にすることで、社内文書や業務データを企業の管理する環境内で取り扱う生成AI基盤を構築できます。
ローカルLLMの構築費用はなぜ大きく変わる?
ローカルLLMには「1ユーザー○円」といった単純な料金表を当てはめにくい特徴があります。
必要となるシステムが企業ごとに異なるためです。特に費用へ影響するのが、次の5つです。
| 1.利用人数
まず、生成AIを何人で利用するかを確認します。
30人程度の特定部門で利用する場合と、300人、1,000人規模で全社利用する場合では、必要なシステム構成が異なります。
| 2.同時利用人数
登録利用者数と同じくらい重要なのが、同時に何人がAIを利用するかです。
例えば300人にアカウントを提供していても、300人全員が同じ瞬間にAIへ質問するとは限りません。
そのため、
といった形で考えます。
今回の設計例では、同時利用者を登録利用者のおおむね1~2割として想定しています。
同時利用人数は、必要なGPU性能や台数を決める重要な要素です。
| 3.利用するLLMの規模
LLMにはさまざまな規模があります。
一般的に、大きなモデルほど必要となるGPUメモリも増加します。
ただし、
とは限りません。
社内FAQ、文書検索、定型的な文章作成など、用途によっては比較的小さなモデルでも必要な品質を満たせる可能性があります。
| 4.GPU
ローカルLLMのインフラ費用で特に大きな割合を占めるのがGPUです。
LLMによる文章生成では大量の計算処理が必要になるため、高性能GPUを利用する構成があります。
モデルの規模、同時利用人数、求める応答速度などによって、必要なGPUメモリやGPU数が変わります。
| 5.RAG・セキュリティ・冗長化など
企業で本格利用する場合、LLMを動かすだけでは十分ではありません。
例えば、
なども必要になります。
そのため、ローカルLLMの予算を考える際には、GPUだけでなく生成AI基盤全体のコストを見ることが重要です。
企業規模別にローカルLLMの構成を考える
ローカルLLMは、最初から大規模なシステムを構築する必要はありません。
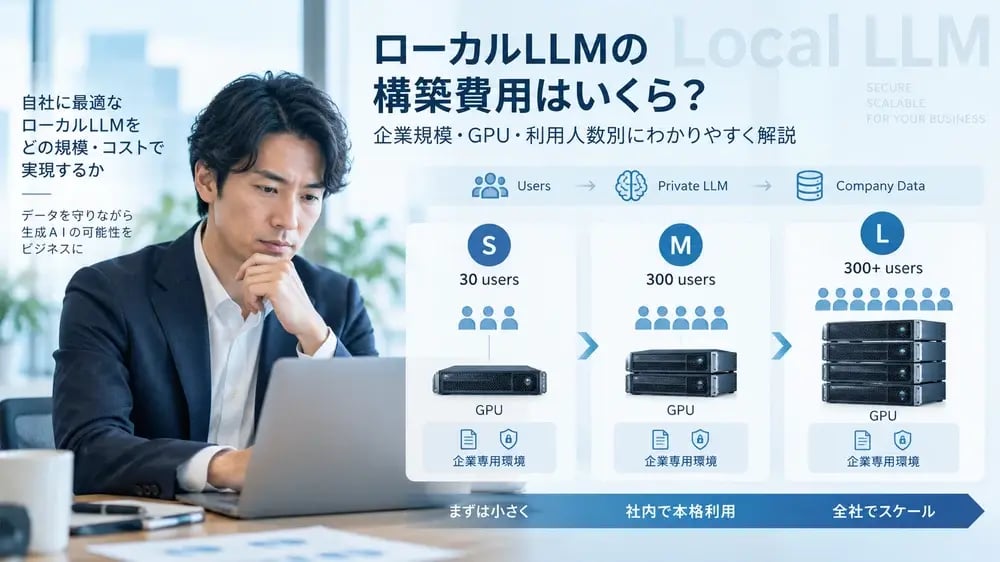
今回の設計例では、利用規模をS・M・Lの3段階に分けています。
|
規模 |
登録利用者の目安 |
主な利用イメージ |
|
S:スモール |
~30人程度 |
PoC、特定部門、小規模利用 |
|
M:スタンダード |
~300人程度 |
複数部門、社内生成AI基盤 |
|
L:エンタープライズ |
300人超 |
全社利用、大規模利用 |
それぞれを詳しく見てみましょう。
S:30人程度まで|まず小さくローカルLLMを始める
S構成は、ローカルLLMをまず限定された範囲で利用するケースです。
例えば、
といった用途が考えられます。
この段階では、最初から大規模な高可用性環境を構築するのではなく、必要最小限の環境から始める方法があります。
重要なのは、自社業務で必要な回答品質と処理性能を確認することです。
M:300人程度まで|社内生成AI基盤として本格利用する
利用者が数百人規模になると、単にLLMが動作するだけではなく、企業システムとしての運用を考える必要があります。
例えば、
などです。
また、社内規程や製品資料などを生成AIから検索したい場合には、RAGを組み合わせることも考えます。
M構成では、
考え方を変える必要があります。
L:300人超|全社利用を想定したエンタープライズ構成
数百人を超える利用者が生成AIを利用する場合、さらに高い処理性能と可用性が求められます。
利用者が増えれば、同時にAIへ問い合わせる人数も増加します。
そのため、複数GPUによる処理や冗長化などを検討します。
また、
なども重要になります。
この規模では単なる「社内チャットAI」ではなく、企業全体で利用する生成AI基盤として設計する必要があります。
ローカルLLMの月額費用はどのくらい?
ローカルLLMの費用を理解するため、クラウド上に構築する場合の概算例を見てみましょう。今回の設計資料では、AWS東京リージョンを前提とした構成例として、GPUと周辺基盤を含む月額費用を試算しています。
大まかな目安として、
というレンジを想定しています。
ただし、この数字だけを見て、
と判断するのは適切ではありません。
これは特定のGPU構成、稼働時間、クラウド環境などを前提とした概算例だからです。特に費用へ大きな影響を与えるのが、GPUの種類・台数と稼働時間です。
なぜローカルLLMはGPU費用が大きいのか?
LLMは、大量の計算処理を行いながら文章を生成します。その処理を高速化するために利用されるのがGPUです。
例えば、
といった条件になるほど、より高性能なGPUや複数GPUが必要になる可能性があります。
今回の試算でも、インフラ費用の大部分をGPUが占める構成になっています。
つまり、ローカルLLMのコスト最適化では、
ことが重要です。
大きなLLMを選べばよいとは限らない
生成AIのモデル選定では、
と考えがちです。
しかし、企業利用ではモデルの大きさだけで判断すべきではありません。
例えば、
といった用途では、比較的小さなモデルでも十分な品質を得られる可能性があります。
モデルが小さくなれば、必要なGPUメモリを削減できる場合があります。
そのため、
ことが重要です。
GPUを24時間動かす必要があるか?
ローカルLLMの費用を左右するもう一つのポイントが稼働時間です。例えば、社内業務で平日の営業時間しか生成AIを利用しないのであれば、24時間365日GPUを稼働させる必要がない場合があります。
今回の設計資料でも、
では、大きな費用差が生じる試算になっています。
そのため、
を事前に確認することが重要です。
ただし、クラウドGPUでは、停止後に再起動すると同じGPUを必ず確保できるとは限らないなど、可用性とのトレードオフもあります。
単純に停止すればよいのではなく、コストと業務継続性のどちらを優先するかを判断する必要があります。
GPU以外に必要となる費用
ローカルLLMの費用を計算するとき、GPUだけを見るのは適切ではありません。
企業向け生成AI基盤では、例えば次のような環境も必要になります。
今回の設計資料では、GPU以外の基盤費用についても規模別に試算しています。
さらに、専用線などを利用する場合は別途費用が発生します。
そのため、ローカルLLMでは、
というTCO(総保有コスト)で判断することが重要です。
RAGを追加すると費用はどう変わる?
企業がローカルLLMを導入する目的として多いのが、社内情報の活用です。
例えば、
などを生成AIから検索・参照できるようにします。
このとき利用されるのがRAG(Retrieval-Augmented Generation:検索拡張生成)です。RAGでは、LLMが持っている知識だけで回答するのではなく、社内文書などを検索し、その情報を参照しながら回答します。
ただし、RAGを追加する場合は、
などの仕組みも必要になります。
したがって、見積もりを行う前に、
を明確にすることが重要です。
クラウドとオンプレミス、どちらが安い?
ローカルLLMという言葉から、
と思われることがあります。
しかし、必ずしもオンプレミスだけを意味するわけではありません。企業専用のクラウド環境に構築する方法もあります。
| クラウド
クラウドでは、GPUサーバーを購入せずに必要な環境を用意できるため、PoCなどから始めやすい特徴があります。
一方、長期間にわたり高性能GPUを常時稼働させる場合には、継続的な利用料金が発生します。
| オンプレミス
オンプレミスではGPUサーバーを購入し、自社環境に設置します。
長期間利用する場合にはクラウドより経済的になる可能性がありますが、
なども考慮する必要があります。
そのため、
で判断します。
AWS・Azure・Google Cloudはどう選ぶ?
企業専用クラウドにローカルLLMを構築する場合、AWS、Microsoft Azure、Google Cloudなどが候補になります。ここで重要なのは、クラウドサービスの名前だけで決めないことです。
特にGPUは、
などによって利用条件が変わります。
そのため、
ではなく、
という順番で考える方が合理的です。
ローカルLLMはPoCから始める
ローカルLLM導入で重要なのが、最初から大規模な本番環境を構築しないことです。
LLMによって、
などが異なります。
そのため、本番導入前にPoC(概念実証)を行います。
例えば、
といった検証を行います。
今回の設計では、PoC環境としてまずGPUインスタンス1台から開始し、LLM推論、利用者向けUI、最低限のセキュリティ、ログ・監視などを組み合わせた小規模構成を想定しています。モデルについても最初から1つに固定するのではなく、候補となる3~5モデル程度を比較し、実際の業務を想定した質問による品質評価や、同時接続時の応答性能を検証してから本番環境を決める考え方です。
PoCの目的は、
重要なのは、
を確認することです。
この結果をもとに、本番環境で必要となるモデル、GPU、RAG、セキュリティ、可用性などを決定します。
ローカルLLMの構築費用を抑える5つのポイント
ローカルLLMのコストを抑えるには、単純に安価なGPUを選ぶのではなく、利用目的に合わせてシステム全体を最適化することが重要です。
| 1.利用人数ではなく「同時利用人数」で考える
社員が300人いるからといって、300人分の同時処理能力が必ず必要になるわけではありません。実際の利用時間や業務内容を分析し、ピーク時の同時利用人数を想定します。これによって、必要以上に大きなGPU環境を用意することを防げます。
| 2.業務に必要以上に大きなLLMを選ばない
モデルが大きくなるほど、一般的に必要となるGPUメモリも増えます。重要なのはモデルの大きさではなく、対象業務で必要な回答品質を満たしているかです。複数のモデルをPoCで比較し、必要な品質を満たす構成を選定します。
| 3.GPUの稼働時間を最適化する
社内利用が平日の営業時間に集中しているのであれば、24時間365日のGPU稼働が本当に必要なのか検討します。営業時間に合わせて稼働時間を調整できれば、クラウドGPUのコストを削減できる可能性があります。ただし、停止・再起動時のGPU確保など運用上の条件もあるため、コストだけではなく可用性とのバランスで判断します。
| 4.必要な機能を段階的に追加する
最初から、
などをすべて構築する必要があるとは限りません。まず必要最小限の環境で検証し、利用部門や用途の拡大に合わせて機能を追加する方法があります。
| 5.PoCの実測値から本番構成を決める
最も重要なのが、机上の想定だけで本番環境を決定しないことです。
実際の業務データや質問を利用して、
を確認します。
その結果から本番構成を決めることで、必要以上のGPU投資を避けやすくなります。
ローカルLLMの導入は「費用」だけで判断しない
ローカルLLMと一般的なクラウド型生成AIを比較すると、ローカルLLMの方が初期構築やインフラ運用に費用がかかる場合があります。
そのため、単純な月額料金だけを比較すると、クラウド型生成AIの方が合理的なケースもあります。
それでもローカルLLMを検討する理由は、
を企業側で設計・管理できる点にあります。
例えば、
といった要件がある企業では、ローカルLLMが選択肢になります。
したがって、
だけで判断するのではなく、
ことが重要です。
ローカルLLMの構築費用に関するよくある質問
Q1. ローカルLLMの構築にはいくらかかりますか?
A. 利用人数、同時利用人数、利用するLLM、GPU、稼働時間、RAG、セキュリティ、可用性などによって大きく異なります。今回の構成例では、クラウドインフラの概算としてS・M・Lの規模別に費用を試算していますが、これは特定条件での参考値です。そのため、最初に業務要件を整理し、PoCで必要な性能を確認したうえで本番環境を見積もることが重要です。
Q2. ローカルLLMで最も費用がかかるのは何ですか?
A. 構成によりますが、高性能なLLMをクラウドで稼働させる場合、GPUがインフラ費用の大きな割合を占めることがあります。モデルの規模、同時利用人数、回答速度などによって必要なGPU性能が変わるため、PoCによる適切なサイジングが重要です。
Q3. 30人程度の利用でもローカルLLMを構築できますか?
A. 可能です。今回の設計でも、30人程度までをS(スモール)として想定しています。特定部署から導入したり、PoCとして小規模に開始したりして、効果を確認してから利用範囲を広げる方法があります。
Q4. 300人の社員が利用する場合、300人分のGPU処理能力が必要ですか?
A. 必ずしも必要ではありません。重要なのは登録利用者数だけではなく、ピーク時に何人が同時利用するかです。300人が登録していても、同時に利用する人数が30~60人程度であれば、その利用状況を前提としてGPU構成を検討できます。実際の利用パターンをPoCで測定することが重要です。
Q5. 大きなLLMを利用した方がよいのでしょうか?
A. 必ずしもそうではありません。高性能な大規模モデルが必要な業務もありますが、社内FAQ、文書検索、要約などでは、より小さなモデルでも必要な品質を満たせる可能性があります。モデルの大きさではなく、自社業務で求める品質・速度・コストのバランスから選択します。
Q6. RAGを利用すると費用は高くなりますか?
A. RAGを利用する場合、文書の取り込み、検索、ベクトル化、データベースなどの仕組みが追加で必要になります。そのため、LLM単体の構成よりシステム要素は増えます。一方で、社内文書を検索して回答することが目的であれば、RAGは重要な構成要素になります。「RAGが必要かどうか」ではなく、生成AIに何をさせたいのかから判断することが重要です。
Q7. オンプレミスとクラウドではどちらが安いですか?
A. 利用期間、GPU、利用時間、保守体制などによって異なるため、一概にはいえません。クラウドはGPUサーバーを購入せずに始められるため、PoCや段階的な導入に向いています。オンプレミスはGPUサーバーの購入が必要ですが、長期間・高稼働率で利用する場合には選択肢となります。初期費用だけではなく、数年間のTCOで比較することが重要です。
Q8. ローカルLLMなら社内データが外部へ出ることはありませんか?
A. そのような設計は可能ですが、「ローカルLLMだから自動的に安全」というわけではありません。ネットワーク、外部API接続、認証、アクセス権限、ログ、データ保存、バックアップなどを含めて設計する必要があります。今回想定する構成では、通常運用で外部LLM APIを利用せず、顧客専用環境内でLLMを稼働させることを基本方針としています。
Q9. ローカルLLMでも社内文書を検索できますか?
A. RAGを組み合わせることで可能です。社内規程、マニュアル、技術資料、FAQなどを検索し、関連情報を取得したうえでLLMが回答を生成する仕組みを構築できます。ただし、企業利用では「検索できるか」だけでなく、利用者が閲覧権限を持つ情報だけを検索できるようにすることも重要です。
Q10. AWS以外でもローカルLLMを構築できますか?
A. 可能です。今回の基本設計はAWSを初期実装の対象としていますが、AzureやGoogle Cloudへの展開も考慮した設計です。
また、企業要件によってはオンプレミス環境も選択肢になります。特定クラウドありきではなく、必要なGPU、セキュリティ、既存システム、運用体制などから適切な環境を選択します。
Q11. ローカルLLM導入前のPoCでは何を確認すればよいですか?
A. 少なくとも、
などを確認します。
特に、一般的なベンチマークだけではなく、実際の自社業務を想定した質問やデータで評価することが重要です。
Q12. ローカルLLMはどのような企業に向いていますか?
A. 例えば、
などが検討対象になります。
一方、機密情報をほとんど扱わず、一般的な生成AI機能だけを利用したい場合には、クラウド型生成AIサービスの方が合理的なケースもあります。
まとめ|ローカルLLMの費用は「何人で使うか」だけでは決まらない
ローカルLLMの構築費用は、
などの組み合わせによって決まります。
そのため、
という質問に対して、すべての企業に共通する一つの金額を提示することはできません。
重要なのは、最初から最大規模の環境を構築することではなく、
という順序で検討することです。
これによって、セキュリティを確保しながら、必要以上のGPU投資を避け、自社に適したローカルLLM環境を構築しやすくなります。
自社に適したローカルLLM環境を検討する
デフィデでは、企業の業務要件、セキュリティ要件、利用人数、利用するデータなどを整理し、ローカルLLM/プライベートLLM環境の設計・構築を支援しています。

最初から大規模な環境を構築するのではなく、ユースケース整理、モデル選定、PoC、GPUサイジング、RAG、セキュリティ設計から本番導入・運用まで、企業ごとの要件に合わせて検討します。

 media